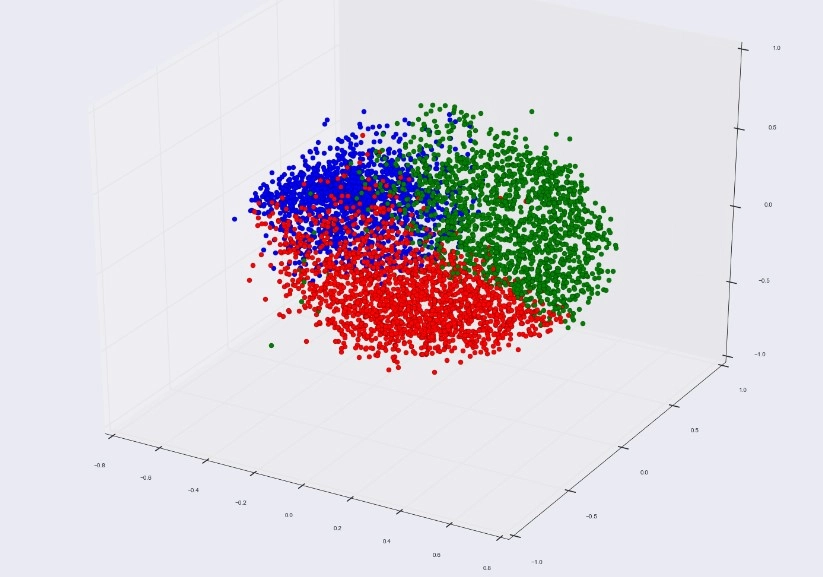
Анализ главных компонент (PCA) и кластерный анализ (CA) - это два различных метода статистического анализа данных, которые используются для обработки и суммирования информации о многомерных датасетах. Оба способа позволяют выделить наиболее значимые факторы или группы данных, упрощая их интерпретацию и облегчая последующий анализ.
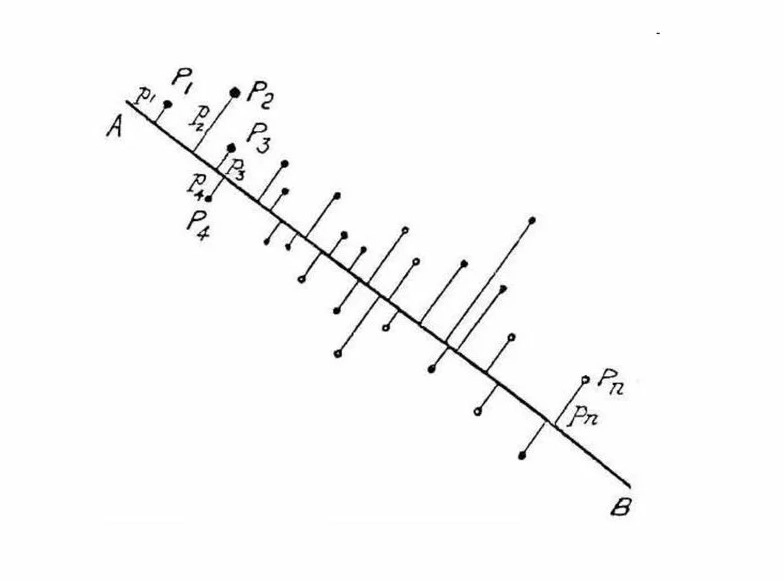
PCA является методом преобразования исходных переменных в новые независимые переменные, называемые главными компонентами (PCs). Первый PC соответствует наибольшей части дисперсии, второй - следующей по величине, и т.д. Данные переменные могут быть использованы для уменьшения размерности исходного датасета, выделения основных трендов и упрощения дальнейшего анализа.
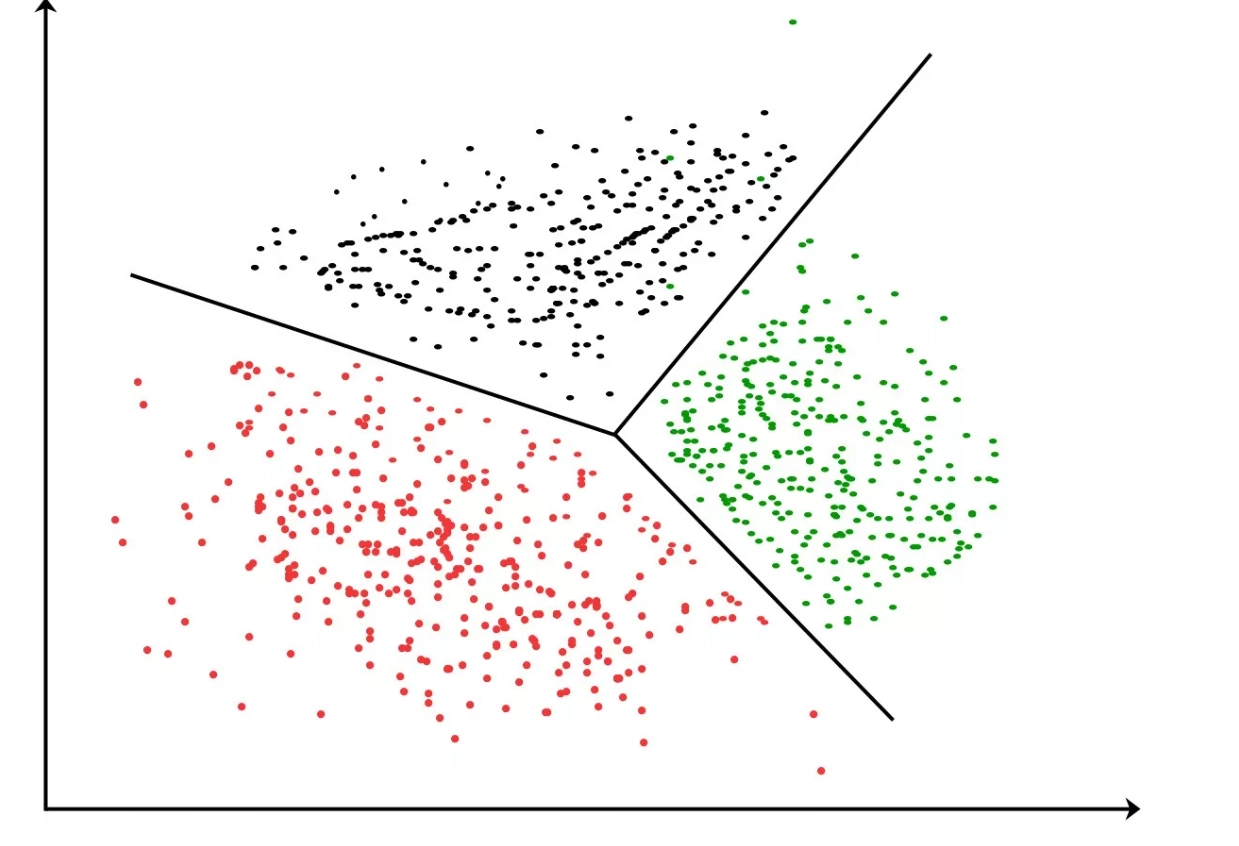
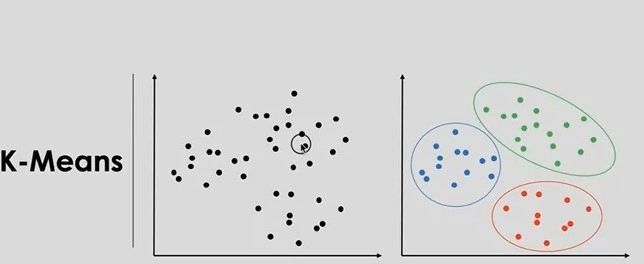
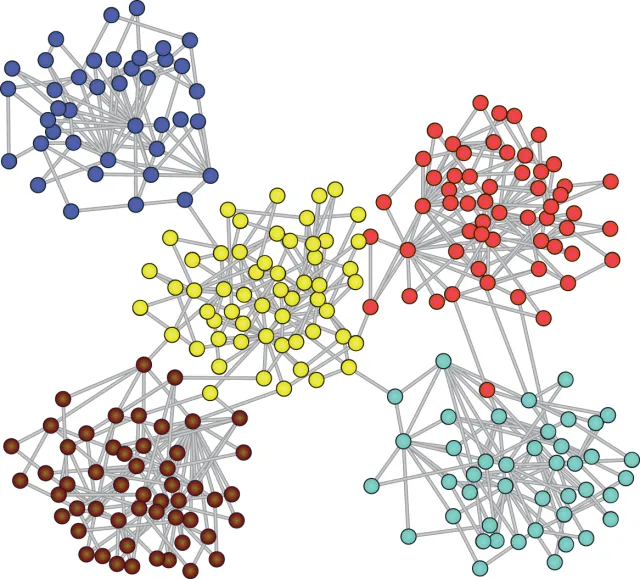
CA, с другой стороны, является методом объединения в кластеры данных на группы на основе сходства между наблюдениями. Сформированные кластеры могут быть использованы для выделения общих моделей поведения или характеристик, выявления аномалий или нетипичных элементов.
Одним из преимуществ PCA является возможность упрощения данных до нескольких главных компонент, что уменьшает количество переменных и повышает интерпретируемость результата. Однако, PCA может не учитывать важные различия между исходными переменными и скрытую двойственность в данных.
CA может лучше подходить для идентификации скрытых групп в данных, что полезно для поиска паттернов и описания сложных взаимодействий между переменными. Однако, CA требует настройки различных параметров и выбора определенных мер подобности, и может быть менее точным при обработке шума или сильно пересекающихся групп.
Вместе PCA и CA могут использоваться для получения более полного исследования данных, позволяя обнаружить скрытые корреляции между переменными и выделить их наиболее значимые группы.
Кластерный анализ - это метод многомерного статистического анализа, который используется для выделения групп схожих объектов или событий. Кластерный анализ может быть использован в различных областях, включая биологию, экономику, социологию, компьютерные науки.
Процесс кластерного анализа включает в себя группировку данных на основе их сходства или расстояния между ними. Например, если у нас есть данные о покупках клиентов в интернет-магазине, мы можем использовать кластерный анализ, чтобы выделить группы клиентов с похожими покупательскими поведениями.
Кластерный анализ имеет несколько типов, включая иерархический и неиерархический кластерный анализ. В иерархическом кластерном анализе мы строим дерево, которое показывает, как объекты группируются в кластеры. В неиерархическом мы определяем определенное количество кластеров и группируем объекты в соответствии с этим.
Анализ может быть полезен в выявлении очевидных и скрытых паттернов в данных, что может помочь в принятии более информированных решений. Однако, как и любой метод статистического анализа, кластерный анализ должен использоваться с осторожностью и оцениваться в контексте конкретной задачи или проблемы.